من أثر غزالة في الفضاء إلى أرشيف مكاني للكوكب: قراءة علمية في تجارب بلال سيدهو، وحدود إعادة البناء ثلاثي الأبعاد.
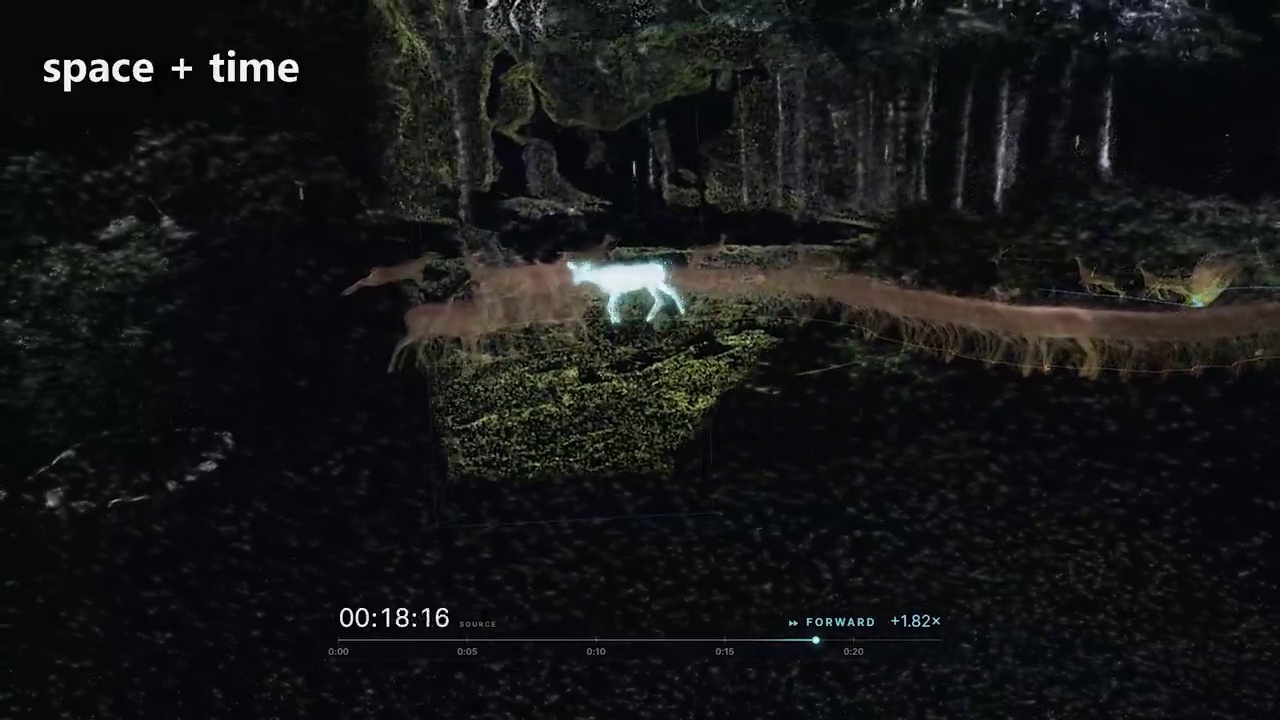
تخيّل أن فيديو غزالة وصغارها لا يختفي إطارًا بعد إطار، بل يترك وراءه هيئة ثلاثية الأبعاد لكل لحظة: حركة الرأس، وموضع الجسد، وخطوات السير. تستطيع التحرك حول هذه الآثار، ومشاهدة الحركة بوصفها شكلًا ممتدًا في المكان. هنا يتغير السؤال من «ماذا حدث في الفيديو؟» إلى «أين حدثت كل لحظة، وكيف يمكن استكشافها؟».
هذه نقطة الانطلاق في فيديو بلال سيدهو على X، المنشور في 30 سبتمبر 2026، والمتاح أيضًا على YouTube. يقترح سيدهو «قصر الذاكرة المكاني»: إعادة ربط الصور والفيديوهات بالأماكن والأوقات التي التُقطت فيها، ثم جمعها داخل مشهد يمكن التنقل فيه. لكن فهم هذه الفكرة علميًا يتطلب التمييز بين المشاهدة الأصلية، والهندسة التي يستنتجها النموذج، وطريقة عرض النتيجة.
ماذا يقول الفيديو؟
يبدأ سيدهو بتجربة الغزلان، ثم يطبق الفكرة على نفسه وهو يمشي. بعدها ينتقل من حركة تستغرق ثواني إلى مشاهد للمكان ذاته عبر الفصول، ثم إلى صور التُقطت في مؤتمر TED، وإعادة تركيب موقع حادث طائرة وبيانات تتبعها، وأخيرًا صور الأقمار الاصطناعية والعواصف. الخيط المشترك هو تحويل الملفات المنفصلة إلى سجل مرتبط بالمكان والزمن.
| بداية الفصل | الفكرة الأساسية |
|---|---|
| 00:45 | تعريف 4D: ثلاثة أبعاد للمكان، والزمن بوصفه البعد الرابع؛ ترك لحظات الفيديو داخل مشهد ثلاثي الأبعاد. |
| 01:44 | تجربة المشي، وتشبيه أدبي لحياة الإنسان بوصفها امتدادًا زمنيًا يمكن تخيل رؤيته دفعة واحدة. |
| 02:32 | تأملات في الإرادة الحرة والسجل الكوني؛ وهي استعارات فلسفية ودينية، وليست نتائج تجريبية. |
| 03:56 | مطابقة فيديوهات شتوية مع نموذج للمكان التُقط في الصيف. |
| 04:43 | ربط صور TED بمواضعها داخل القاعة، ثم تحويلها إلى إسقاطات مكانية. |
| 06:09 | جمع نموذج لموقع حادث الرحلة 7598 مع صور أرضية وبيانات تتبع الطائرة. |
| 07:46 | الانتقال إلى أرشيف الكوكب: صور العواصف وطبقات الرياح والمسارات المتوقعة. |
| 09:53 | تصور أرشيف مشترك يسمح للناس بحفظ ذكريات خاصة والمساهمة طوعًا ببيانات عامة. |
هذا العرض يشرح رؤية وتجارب بصرية. لا يقدم تقييمًا منشورًا لدقة كل إعادة بناء، ولا يسمي نموذجًا بعينه مستخدمًا في تجربة الغزلان. لذلك لا يمكن نسبة جميع النتائج إلى خوارزمية محددة من المشاهدة وحدها.
ما المقصود بأربعة أبعاد هنا؟
للنقطة في مشهد ثلاثي الأبعاد إحداثيات مكانية: x وy وz. إذا أضفنا زمن ظهورها t، أصبح لدينا وصف مكاني زمني: (x, y, z, t). يمكنك عندئذ اختيار زمن واحد ومشاهدة المشهد عنده، أو عرض عينات من أزمنة متعددة معًا لتوضيح مسار الحركة.
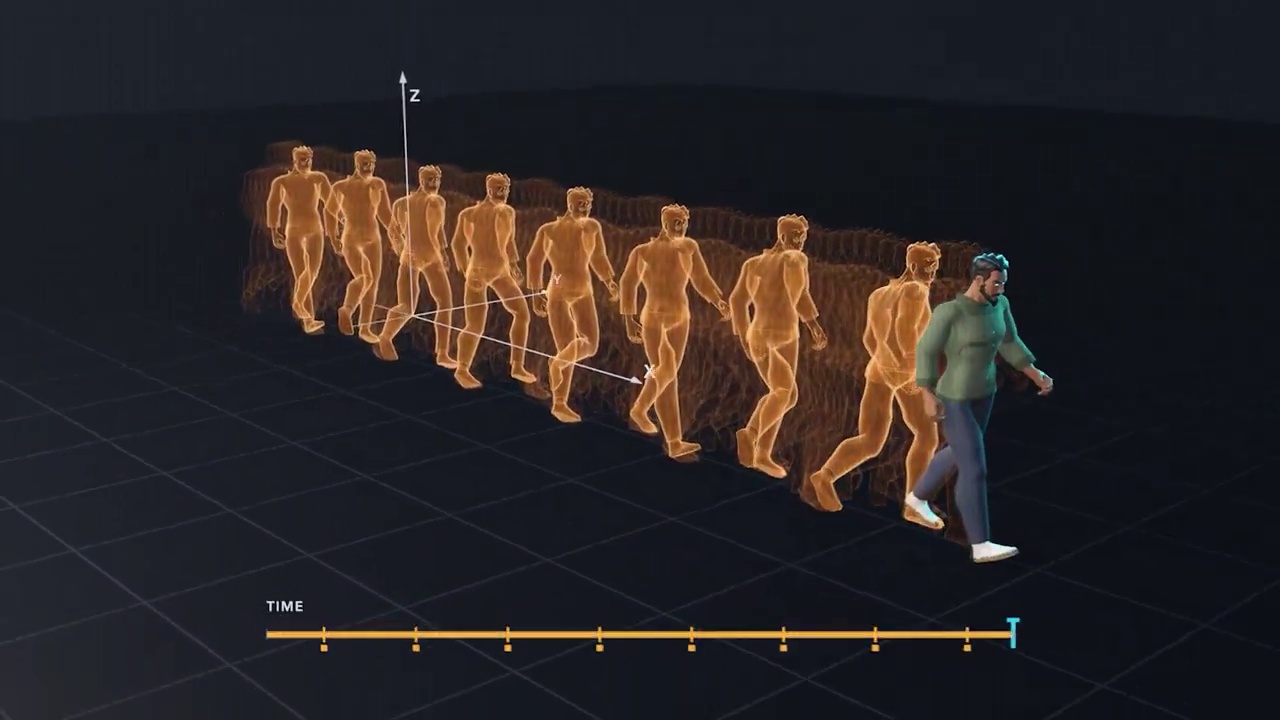
يمكن تشبيه ذلك بتقنية Onion Skinning في التحريك، حيث تظهر أوضاع سابقة أو لاحقة إلى جانب الوضع الحالي لمساعدة الفنان على قراءة الحركة. الجديد في هذه التجربة هو نقل الأوضاع إلى تمثيل مكاني يمكن النظر إليه من زوايا مختلفة.
والفكرة العامة لعرض الزمن بصريًا لها تاريخ أقدم. فقد قدم مشروع Video Summagator، المنشور في CHI عام 2012، واجهة تمثل الفيديو بمكعب مكاني زمني وتتيح استكشافه حجميًا. تمثيل مكعب الفيديو يعتمد على بُعدَي الصورة والزمن؛ أما إعادة بناء المشهد فتهدف إلى استنتاج عمقه المكاني أيضًا. هذا فارق بين ترتيب الصور في حجم، وتقدير بنية العالم المصوَّر.
مصطلح «4D» هنا وصف لبيانات ونموذج حاسوبي. لا يثبت وجود كائنات ترى الزمن كله، ولا يحسم الإرادة الحرة، ولا يتيح السفر الفيزيائي إلى الماضي. هذه الأفكار تدخل في باب التأمل الذي أثارته التجربة، ويجب قراءتها منفصلة عن نتيجتها التقنية.
كيف ننتقل من صورة مسطحة إلى مشهد ثلاثي الأبعاد؟
الصورة تخبرنا بلون كل بكسل، لكنها لا تعطينا تلقائيًا المسافة إلى السطح الذي يمثله. كما أن الشيء الظاهر صغيرًا قد يكون صغيرًا فعلًا أو بعيدًا عن الكاميرا. لذلك تحتاج إعادة البناء إلى معلومات هندسية إضافية أو إلى تقدير يعتمد على ما تعلّمه النموذج.
أولًا، تحديد الكاميرا. نحتاج إلى خصائص العدسة واتجاه الكاميرا وموضعها بالنسبة إلى المشهد. في الأسلوب التقليدي، تُطابق تفاصيل مشتركة بين صور متداخلة التُقطت من زوايا مختلفة. توضح وثائق COLMAP أن Structure-from-Motion يستعيد بنية ثلاثية الأبعاد ومعلمات الكاميرات، ثم يمكن استخدام Multi-View Stereo لبناء تمثيل أكثر كثافة.
ثانيًا، تقدير العمق. تقارن الطرق متعددة المشاهد ظهور التفاصيل بين الصور. وتستطيع نماذج تعلم آلي تقدير خصائص هندسية مباشرة؛ فبحث VGGT، الذي قُدم في CVPR 2025، يستنتج معلمات الكاميرا وخرائط العمق والنقاط وتتبع النقاط ثلاثية الأبعاد من عدد متغير من المشاهد. ويقدم Depth Anything 3 تقديرًا لهندسة متسقة مكانيًا من مدخلات بصرية متعددة، سواء كانت أوضاع الكاميرات معروفة أو غير معروفة. هذان مثالان بحثيان يساعدان على فهم المجال؛ لا يذكر الفيديو أنه استخدم أحدهما.
ثالثًا، وضع البيانات في مرجع مشترك. إذا كان عمق البكسل ومعلمات الكاميرا معروفين، يمكن إرجاعه إلى موضع ثلاثي الأبعاد على الشعاع الذي خرج من الكاميرا نحو السطح. ثم تُحوّل النقاط من مرجع كل كاميرا إلى مرجع المشهد. ومن هنا تتشكل سحابة نقاط ملونة. أما تثبيتها على خريطة العالم، فيحتاج أيضًا إلى ضبط المقياس والاتجاه والموقع الجغرافي.
رابعًا، التعامل مع الحركة والزمن. الشيء المتحرك لا يبقى في موضع واحد بين الصور. إذا عومل كما لو كان ثابتًا، قد تتكرر هندسته أو تتشوه. لهذا يحتاج تمثيل الحركة إلى إسناد النقاط أو الأوضاع إلى أوقاتها، أو إلى نموذج يصف تغير المشهد مع الزمن. تجميع العينات الزمنية في العرض أحد الخيارات؛ وهو لا يكفي وحده لإثبات استمرارية هندسية دقيقة بين جميع اللحظات.
سحابة النقاط وGaussian Splatting: ما الفرق؟
تظهر كثير من المشاهد في الفيديو على هيئة نقاط متناثرة. هذا المظهر لا يكفي لتحديد خوارزمية إعادة البناء. سحابة النقاط تمثل عينات لمواضع في الفضاء، وقد تحمل ألوانًا. أما 3D Gaussian Splatting فيمثل المشهد بعناصر غاوسية ذات أحجام واتجاهات وخصائص مظهر وشفافية، تُسقط على الصورة لإنتاج المنظر المطلوب.
أظهر بحث Kerbl وزملائه عام 2023 أن هذا التمثيل يستطيع إنتاج مناظر جديدة بجودة عالية وعرض سريع في اختبارات الورقة. وفي المشاهد المتغيرة، يقدم بحث 4D Gaussian Splatting المنشور في CVPR 2024 تمثيلًا يجمع عناصر غاوسية ثلاثية الأبعاد مع معلومات مكانية زمنية وشبكة تتنبأ بتشوهاتها عند أزمنة مختلفة.
| المفهوم | ما الذي يصفه؟ | ما الذي لا يضمنه؟ |
|---|---|---|
| سحابة نقاط | عينات مكانية من المشهد | سطحًا مكتملًا أو تفاصيل الجهات المحجوبة |
| تقدير العمق | المسافة المقدَّرة باتجاه كل بكسل | صحة هندسية مطلقة لكل تفصيل |
| Gaussian Splatting | تمثيلًا للمظهر يساعد على توليد مناظر | تطابقًا مساحيًا دقيقًا لمجرد أن الصورة مقنعة |
| تمثيل 4D | تغير مشهد ثلاثي الأبعاد مع الزمن | تسجيل كل الأحداث أو معرفة المستقبل |
هذه تقنيات ومفاهيم متصلة، لكنها تؤدي أدوارًا مختلفة. يمكن للعرض أن يبدو واقعيًا بينما تظل بعض هندسته غير مؤكدة.
حين يصبح للمكان أكثر من زمن
أحد أكثر أمثلة الفيديو وضوحًا هو ربط فيديوهات الشتاء بنموذج مكاني التُقط في الصيف. يصف سيدهو مطابقة مواقع التصوير مع النموذج، ثم إسقاط الفيديو داخل المكان. عندئذ يمكن الانتقال بين ذكريات للموقع نفسه بدل تقليب مستطيلات في ألبوم.
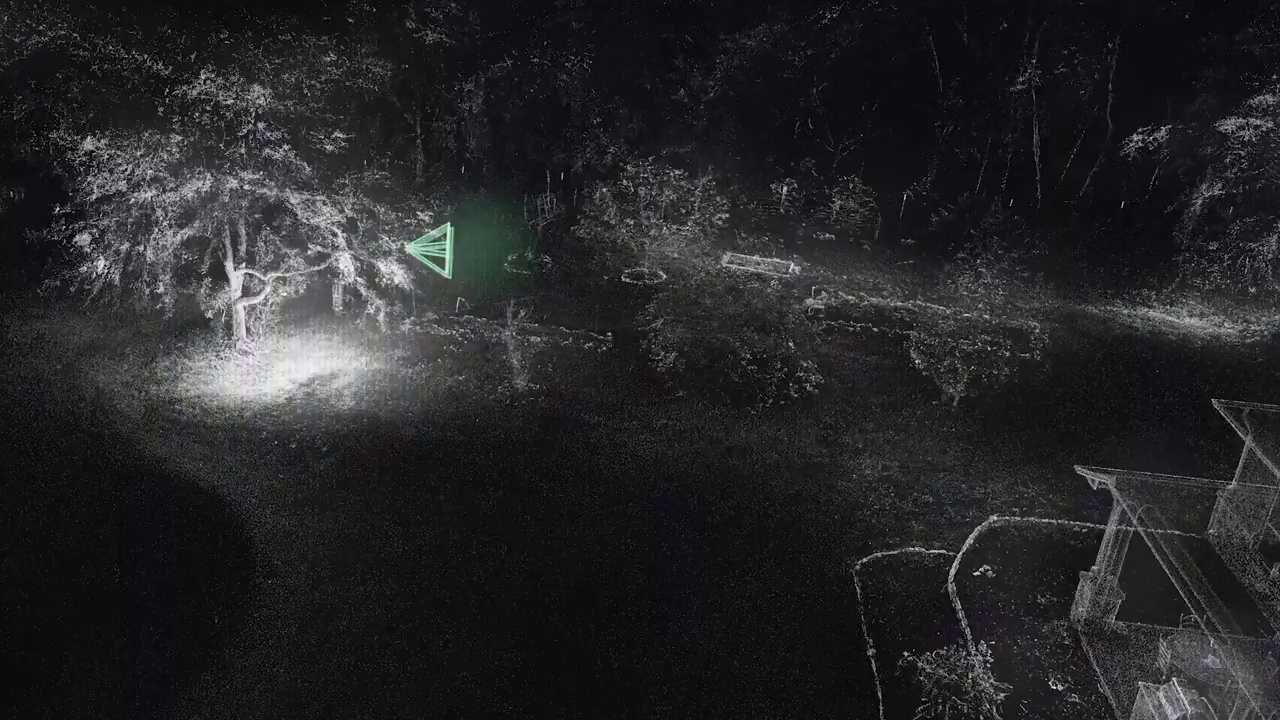
وهنا توجد مشكلة هندسية مهمة: المكان يتغير. الأشجار تنمو، والأثاث ينتقل، والإضاءة والثلوج تخفي تفاصيل كانت مرئية. لذلك ينبغي التمييز بين محاذاة البنية الثابتة للموقع وبين إسقاط عناصر التُقطت في وقت آخر. جمعهما في واجهة واحدة لا يجعل زمنيهما واحدًا.
في مثال TED، يصف سيدهو استخدام صور عامة منشورة بتراخيص Creative Commons، إلى جانب صوره، وربطها بمواضع التصوير داخل القاعة. يمكن بعد ذلك البحث عن ظهور شخص في الصور، أو الانتقال إلى الكواليس، أو تجميع إسقاطات لمتحدثين وأزمنة مختلفة.
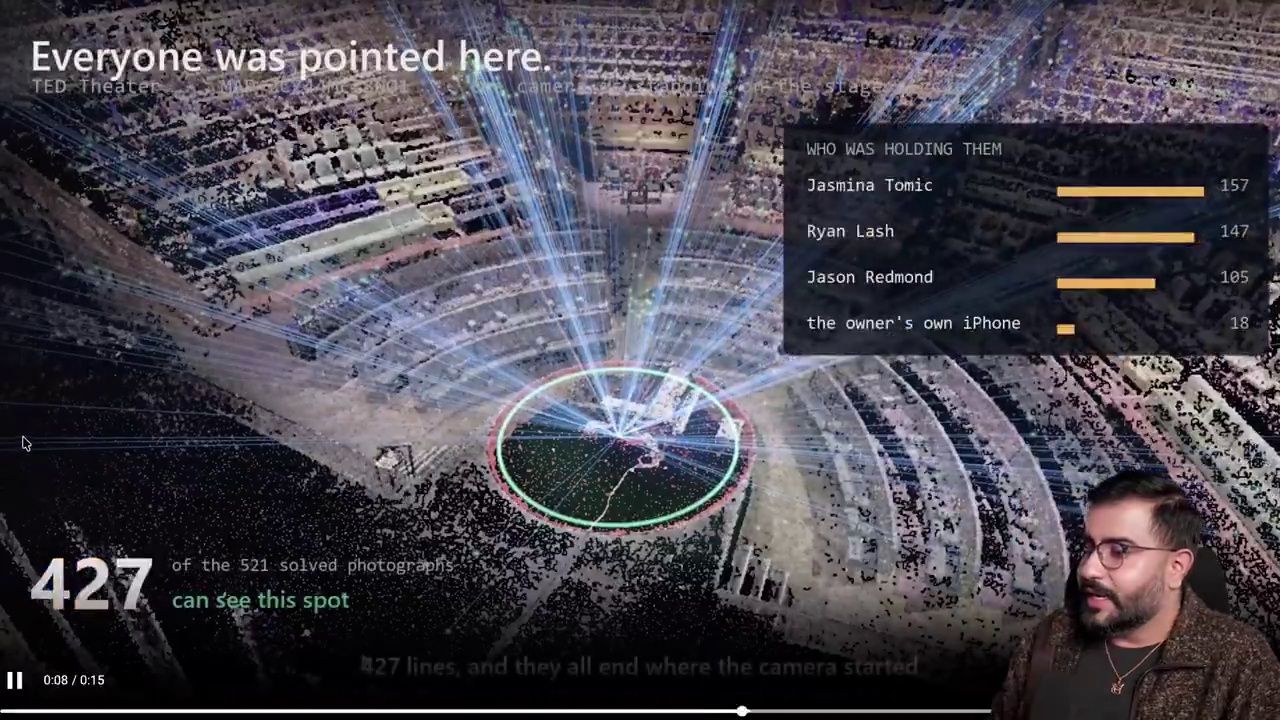
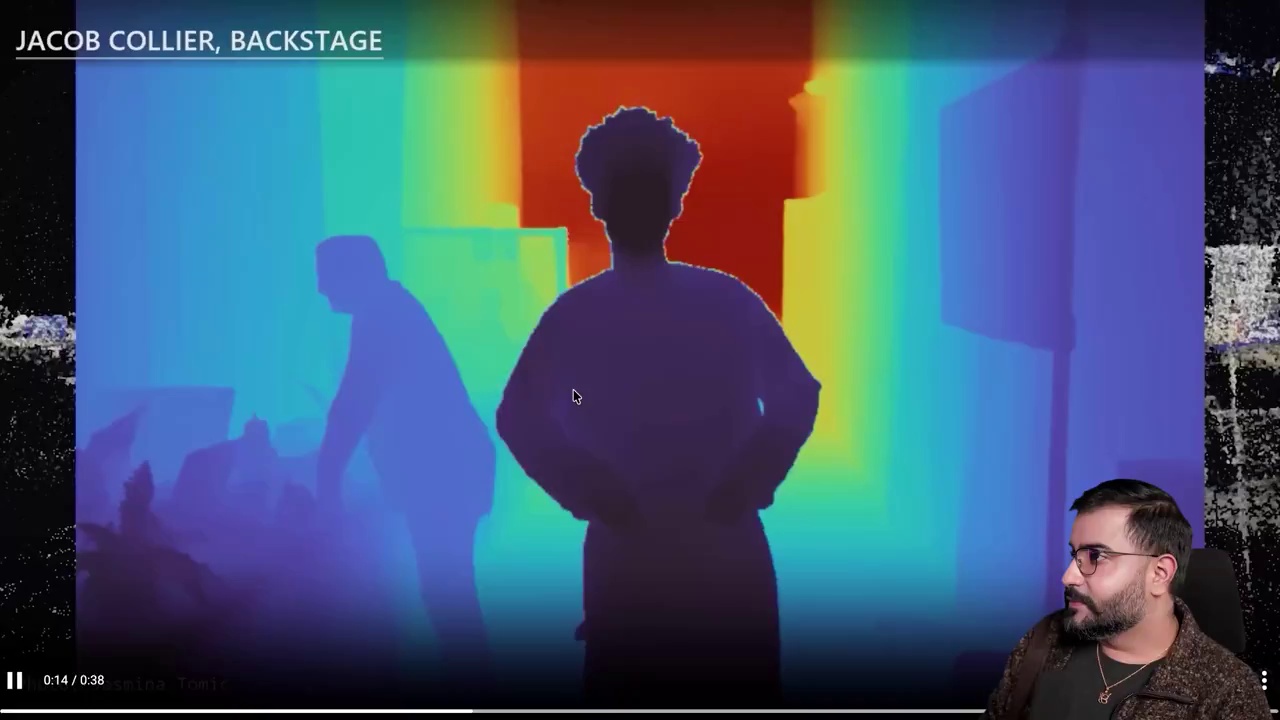
إعادة إسقاط صورة باستخدام عمقها قد تمنحها حجمًا وتسمح بتغيير محدود لزاوية النظر. لكنها لا تستعيد تلقائيًا ما كان خلف الشخص أو خارج الإطار. كلما ابتعدت زاوية العرض عن زاوية الالتقاط، ظهرت الحاجة إلى مشاهد إضافية أو إلى استنتاج أجزاء لم تُرصد أصلًا. ولهذا فالأرشيف المكاني الجيد يحتفظ بالصورة الأصلية إلى جانب إعادة بنائها.
إعادة تركيب حدث: السياق لا يكفي وحده لإثبات السبب
في فصل الرحلة 7598، يقول سيدهو إنه استخدم تصويرًا جويًا أصدره NTSB لبناء نموذج لموقع الحادث، ثم أضاف بيانات تتبع الطائرة وصورًا أرضية. الفائدة البصرية واضحة: يمكن فهم العلاقة بين المدرج، وآثار الحركة، وموضع الحطام، والصور القريبة ضمن مرجع واحد.
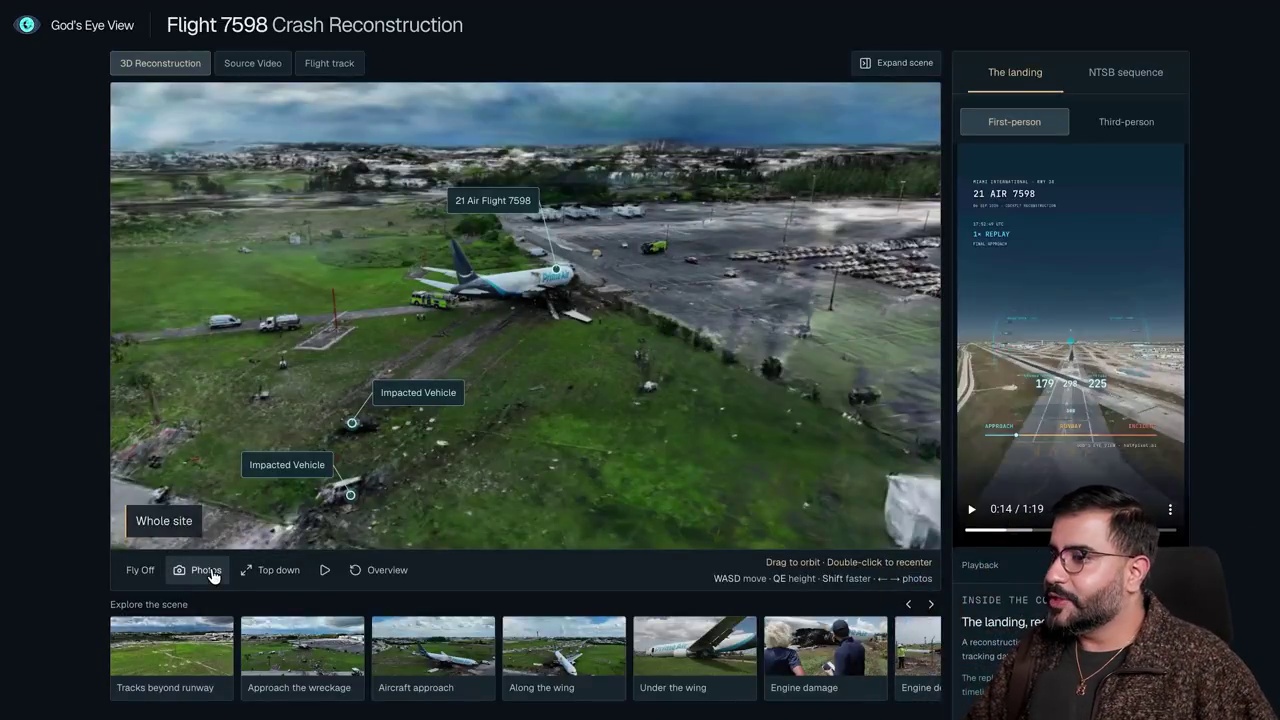
لكن وضع المصادر فوق بعضها لا يجعلها متزامنة تلقائيًا: قد تُلتقط صورة أرضية بعد الحادث بساعات، وقد تأتي بيانات التتبع على فواصل زمنية مختلفة. كذلك فإن خطًا يصل بين نقطتي تتبع قد يكون استيفاءً للعرض، وليس قياسًا مباشرًا لكل المواضع بينهما.
من هنا تأتي أهمية ثلاثة أسئلة: ما مصدر كل عنصر؟ متى سُجل؟ وما الذي أُضيف بالاستنتاج أو النمذجة؟ يمكن لهذا التنظيم أن يوضح الأدلة المتاحة ويساعد على فحص فرضيات، لكنه لا يثبت سبب حادث بمجرد إعادة تشغيله بصريًا.
ذاكرة الكوكب: الرصد والتوقع طبقتان مختلفتان
ينتهي الفيديو إلى صور الأقمار الاصطناعية ومسارات العواصف وطبقات الرياح. وهو مثال مناسب لفكرة أرشيف مكاني زمني واسع: اختيار منطقة وتاريخ، ثم مشاهدة تغيرها عبر قياسات وصور متتابعة.
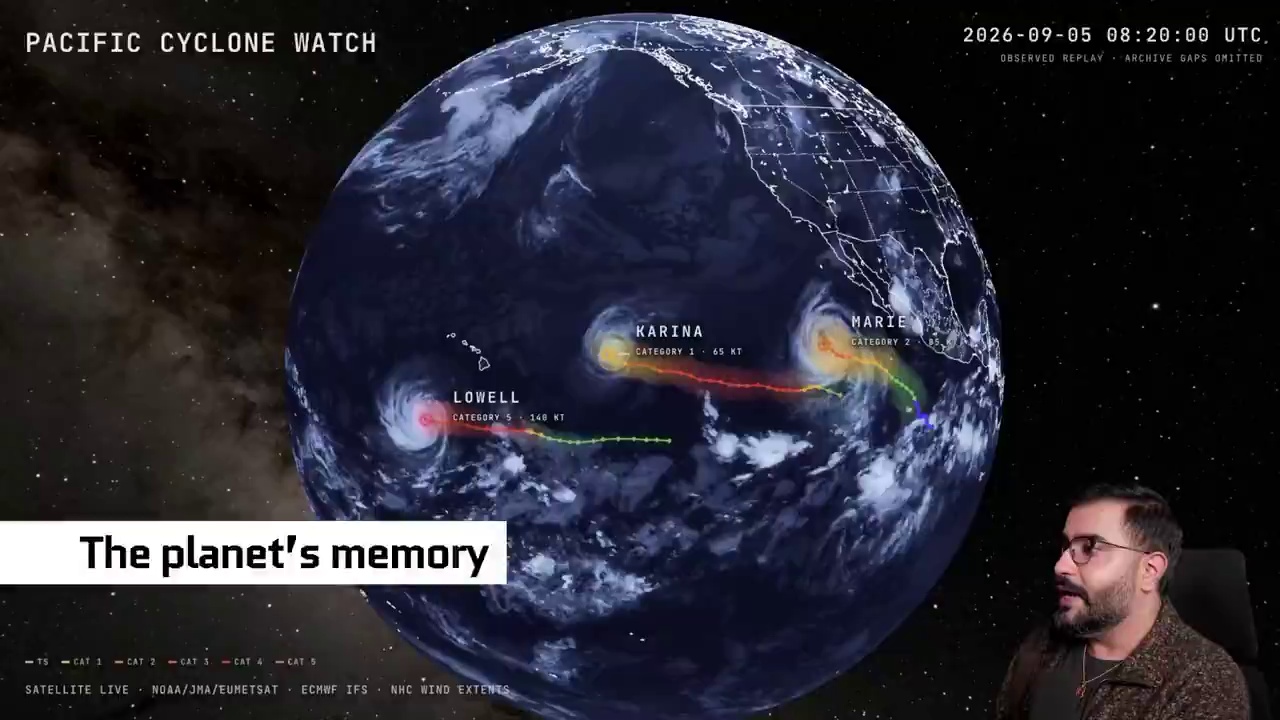
وتحتاج قراءة هذه الواجهة إلى الفصل بين الرصد، أي بيانات مستمدة من قياسات وصور، والتوقع، أي ناتج نموذج يقدّر حالة لاحقة. توضح NOAA أن التنبؤ العددي بالطقس يعالج الرصد الحالي داخل إطار النموذج لإنتاج توقعات مستقبلية. ويمكن أن تتغير النتائج عند وصول قياسات جديدة.
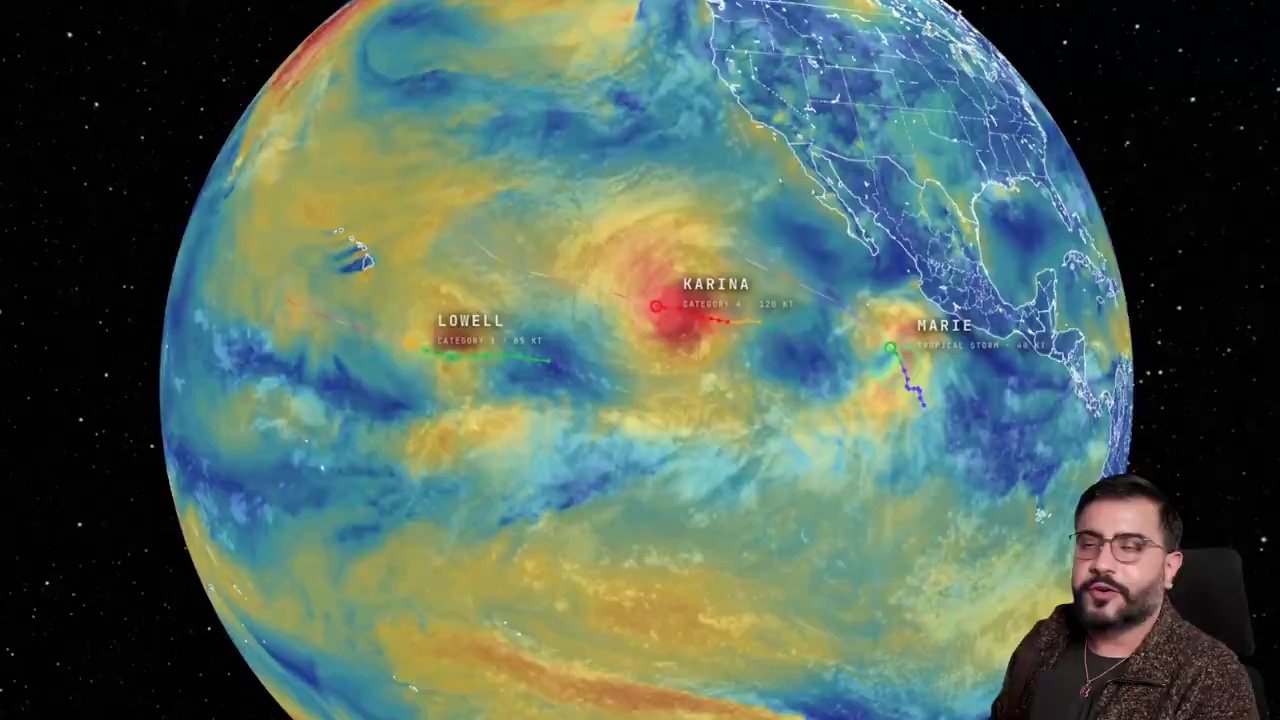
وفي مثال محدد لعدم اليقين، يعرّف المركز الوطني الأمريكي للأعاصير مخروط توقع المسار التشغيلي بوصفه نطاقًا لمسار مركز الإعصار مبنيًا على أخطاء توقع تاريخية. ليس حدودًا لكل تأثيرات العاصفة. إذن، الجمع بين الماضي المرصود والمستقبل المتوقع مفيد، بشرط أن تبقى دلالة كل طبقة ظاهرة للقارئ.
ما الذي يجعل هذا الأرشيف علميًا وقابلًا للثقة؟
اقتراحي لتقييم مثل هذه الأنظمة هو ألا نكتفي بجمال النتيجة. الأرشيف القابل للفحص يحتاج إلى الصورة أو القياس الأصلي، وزمن الالتقاط منفصلًا عن زمن الرفع، ومرجع مكاني ومقياس واضحين، وإصدار النموذج المستخدم، وتمييز الأجزاء المرصودة عن المستنتجة، وطريقة لعرض الخطأ أو محدودية الثقة. وإذا تغيّر التقدير، ينبغي الاحتفاظ بما يفسر سبب التغيير.
توضح وثائق مشروع God’s Eye View الأصلي بالفعل أن بعض الطبقات تعتمد على بيانات حية، وبعضها على محاكاة أو تقديرات تقريبية؛ فالمركبات المرسومة في طبقة المرور لا تعني رصد كل مركبة فعلية. هذه نقطة منهجية مهمة: المعلومات الحقيقية قد تُعرض داخل مشهد يحتوي أيضًا على عناصر نموذجية.
وفي الذكريات الشخصية، يجب أن يكون قرار مشاركة المواد واضحًا. الصورة قد تسجل منزلًا أو وجهًا أو مكانًا خاصًا؛ وربط الصور ببعضها يكشف سياقًا أوسع مما تكشفه كل صورة بمفردها. يقترح سيدهو الاحتفاظ بما يريد المستخدم إبقاءه خاصًا، والمساهمة اختياريًا بالمحتوى العام. هذه رؤية تحتاج، عند تحويلها إلى منتج، إلى صلاحيات مفهومة وتحكم في الإزالة والمشاركة.
لماذا تهم هذه الفكرة المصمم والباحث؟
يمكن تصور تطبيقات في توثيق الأماكن والتراث، ومقارنة تغير موقع على فترات متباعدة، وعرض مادة تعليمية مرتبطة بمكانها، وبناء تجارب تفاعلية للذكريات. وبالنسبة إلى مصمم الوسائط المتعددة، تصبح مهمة التصميم أعمق من ترتيب الصور: عليه أن يشرح للقارئ أين يقف، وأي زمن يشاهد، وما مصدر العنصر أمامه، وما مقدار اليقين فيه.
تجربة سيدهو تلفت الانتباه إلى تحول مهم في واجهات المعرفة: من ملف نبحث عنه في مجلد إلى واقعة نصل إليها عبر المكان والزمن. قوتها العلمية المحتملة تأتي من قابلية المصادر للمقارنة والفحص، لا من الإيحاء بأننا امتلكنا رؤية كاملة للعالم. قد يصبح لكل مكان أرشيف نستكشفه، لكن صدق هذا الأرشيف يبدأ بإظهار ما نعرفه، وكيف عرفناه، وأين تنتهي البيانات.
عن المادة والصور: هذه تدوينة تحليلية أصلية مبنية على مراجعة النص الإنجليزي الآلي للفيديو ومشاهدة لقطات منه ومقارنتها بالمراجع أدناه، وليست ترجمة حرفية للنص. جميع الصور الثماني لقطات أصلية مستخرجة من الفيديو دون توليد أو تغيير محتواها، مع إبقاء النسب الظاهرة داخل الإطار. الحقوق لأصحابها، وتُستخدم هنا لشرح الأمثلة ومناقشتها. لا يمتد ترخيص الشفرة البرمجية تلقائيًا إلى صور الفيديو أو بيانات الجهات الثالثة.
المراجع
- الفيديو المصدر على X ونسخته على YouTube.
- Nguyen, Niu & Liu — Video Summagator، CHI 2012.
- COLMAP — الشرح الرسمي لإعادة البناء من الصور.
- Wang et al. — VGGT، CVPR 2025.
- Lin et al. — Depth Anything 3، 2025.
- Kerbl et al. — 3D Gaussian Splatting، SIGGRAPH 2023.
- Wu et al. — 4D Gaussian Splatting، CVPR 2024.
- NOAA NCEI — التنبؤ العددي بالطقس.
- NHC — تعريف مخروط توقع المسار.
- مستودع God’s Eye View الأصلي.
تاريخ مراجعة المصادر: 30 سبتمبر 2026.